
Transformers documentation
FastSpeech2Conformer
نُشر هذا النموذج في أوراق HF في 26 أكتوبر 2020، وأُضيف إلى مكتبة Hugging Face Transformers في 3 يناير 2024.
FastSpeech2Conformer
نظرة عامة
قُدِّم نموذج FastSpeech2Conformer في ورقة Recent Developments On Espnet Toolkit Boosted By Conformer التي كتبها Pengcheng Guo و Florian Boyer و Xuankai Chang و Tomoki Hayashi و Yosuke Higuchi و Hirofumi Inaguma و Naoyuki Kamo و Chenda Li و Daniel Garcia-Romero و Jiatong Shi و Jing Shi و Shinji Watanabe و Kun Wei و Wangyou Zhang و Yuekai Zhang.
المستخلص من ورقة FastSpeech2 الأصلية هو كالتالي:
يمكن لنماذج تحويل النص إلى كلام غير التوليدية الذاتية (TTS) مثل FastSpeech (Ren et al., 2019) توليد الكلام بشكل أسرع بكثير من نماذج التوليد الذاتي السابقة مع جودة مماثلة. يعتمد تدريب نموذج FastSpeech على نموذج مُعلِّم توليدي ذاتي للتنبؤ بالمدة (لتوفير مزيد من المعلومات كمدخلات) والتقطير المعرفي (لتبسيط توزيع البيانات في المخرجات)، مما يمكن أن يخفف من مشكلة التحويل من واحد إلى متعدد (أي أن عدة تباينات في الكلام تقابل النص نفسه) في TTS. ومع ذلك، فإن FastSpeech يعاني من عدة عيوب: 1) خط أنابيب التقطير بين المُعلِّم والتلميذ معقد ويستغرق وقتًا طويلاً، 2) المدة المستخرجة من نموذج المُعلِّم ليست دقيقة بما يكفي، كما أن مطيافات الميل المستهدفة المُقطَّرة من نموذج المُعلِّم تعاني من فقدان المعلومات بسبب تبسيط البيانات، وكلاهما يحدّ من جودة الصوت. في هذه الورقة، نقترح FastSpeech 2، الذي يعالج المشكلات في FastSpeech ويحل مشكلة التحويل من واحد إلى متعدد في TTS بشكل أفضل من خلال 1) تدريب النموذج مباشرةً باستخدام الهدف الحقيقي بدلاً من المخرج المبسّط من المُعلِّم، و2) إدخال مزيد من معلومات التباين في الكلام (مثل النغمة والطاقة والمدة الأكثر دقة) كمدخلات شرطية. على وجه التحديد، نستخرج المدة والنغمة والطاقة من موجة الكلام ونستخدمها مباشرةً كمدخلات شرطية في التدريب، ونستخدم القيم المتوقعة في الاستدلال. كما نصمم FastSpeech 2s، وهو أول محاولة لتوليد موجة الكلام مباشرةً من النص بالتوازي، مستفيدًا من فائدة الاستدلال النهائي الشامل. تُظهر النتائج التجريبية أن 1) يحقق FastSpeech 2 تسريعًا في التدريب بمقدار 3 أضعاف مقارنةً بـ FastSpeech، ويتمتع FastSpeech 2s بسرعة استدلال أسرع حتى؛ 2) يتفوق FastSpeech 2 و2s على FastSpeech في جودة الصوت، بل يمكن لـ FastSpeech 2 أن يتجاوز نماذج التوليد الذاتي. تتوفر عينات صوتية على https://speechresearch.github.io/fastspeech2/.
تمت مساهمة هذا النموذج من قِبل Connor Henderson. يمكن العثور على الكود الأصلي هنا.
🤗 بنية النموذج
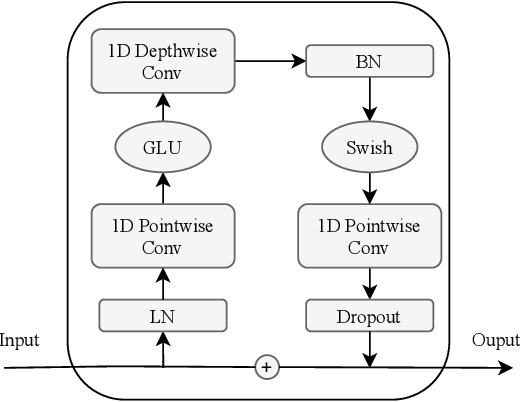
تم تنفيذ البنية العامة لنموذج FastSpeech2 مع مُفكّك طيف الميّل (Mel-spectrogram decoder)، واستُبدلت كتل الترانسفورمر التقليدية بكتل الكونفورمر (conformer blocks) على غرار ما تم في مكتبة ESPnet.
بنية نموذج FastSpeech2

كتل Conformer

وحدة الالتفاف
🤗 استخدام Transformers
يمكنك تشغيل FastSpeech2Conformer محليًا باستخدام مكتبة 🤗 Transformers.
- أولاً، ثبّت مكتبة Transformers 🤗 وg2p-en:
pip install --upgrade pip
pip install --upgrade transformers g2p-en
- شغّل الاستدلال عبر كود نمذجة Transformers باستخدام النموذج وhifigan بشكل منفصل
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerModel, FastSpeech2ConformerTokenizer


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer", device_map="auto")
output_dict = model(input_ids, return_dict=True)
spectrogram = output_dict["spectrogram"]

hifigan = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
waveform = hifigan(spectrogram)

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- شغّل الاستدلال عبر كود نمذجة Transformers مع دمج النموذج وhifigan
import soundfile as sf

from transformers import FastSpeech2ConformerTokenizer, FastSpeech2ConformerWithHifiGan


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
output_dict = model(input_ids, return_dict=True)
waveform = output_dict["waveform"]

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- شغّل الاستدلال باستخدام خط أنابيب وحدد أي مُصوِّت صوتي (vocoder) يجب استخدامه
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, pipeline


vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
synthesiser = pipeline(model="espnet/fastspeech2_conformer", vocoder=vocoder)

speech = synthesiser("Hello, my dog is cooler than you!")

sf.write("speech.wav", speech["audio"].squeeze(), samplerate=speech["sampling_rate"])
FastSpeech2ConformerConfig
فئة transformers.FastSpeech2ConformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truehidden_size: int = 384vocab_size: int = 78num_mel_bins: int = 80encoder_num_attention_heads: int = 2encoder_layers: int = 4encoder_linear_units: int = 1536decoder_layers: int = 4decoder_num_attention_heads: int = 2decoder_linear_units: int = 1536speech_decoder_postnet_layers: int = 5speech_decoder_postnet_units: int = 256speech_decoder_postnet_kernel: int = 5positionwise_conv_kernel_size: int = 3encoder_normalize_before: bool = Falsedecoder_normalize_before: bool = Falseencoder_concat_after: bool = Falsedecoder_concat_after: bool = Falsereduction_factor: int = 1speaking_speed: float = 1.0use_macaron_style_in_conformer: bool = Trueuse_cnn_in_conformer: bool = Trueencoder_kernel_size: int = 7decoder_kernel_size: int = 31duration_predictor_layers: int = 2duration_predictor_channels: int = 256duration_predictor_kernel_size: int = 3energy_predictor_layers: int = 2energy_predictor_channels: int = 256energy_predictor_kernel_size: int = 3energy_predictor_dropout: float | int = 0.5energy_embed_kernel_size: int = 1energy_embed_dropout: float | int = 0.0stop_gradient_from_energy_predictor: bool = Falsepitch_predictor_layers: int = 5pitch_predictor_channels: int = 256pitch_predictor_kernel_size: int = 5pitch_predictor_dropout: float | int = 0.5pitch_embed_kernel_size: int = 1pitch_embed_dropout: float | int = 0.0stop_gradient_from_pitch_predictor: bool = Trueencoder_dropout_rate: float | int = 0.2encoder_positional_dropout_rate: float | int = 0.2encoder_attention_dropout_rate: float | int = 0.2decoder_dropout_rate: float | int = 0.2decoder_positional_dropout_rate: float | int = 0.2decoder_attention_dropout_rate: float | int = 0.2duration_predictor_dropout_rate: float | int = 0.2speech_decoder_postnet_dropout: float | int = 0.5max_source_positions: int = 5000use_masking: bool = Trueuse_weighted_masking: bool = Falsenum_speakers: int | None = Nonenum_languages: int | None = Nonespeaker_embed_dim: int | None = Noneconvolution_bias: bool = True )
المعاملات
- is_encoder_decoder (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان النموذج يُستخدم كمُشفِّر/مُفكِّك أم لا. - hidden_size (
int، اختياري، القيمة الافتراضية384) — أبعاد التمثيلات المخفية. - vocab_size (
int، اختياري، القيمة الافتراضية78) — حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطةinput_ids. - num_mel_bins (
int، اختياري، القيمة الافتراضية80) — عدد ميزات mel المستخدمة لكل إطار إدخال. يجب أن يتوافق مع القيمة المستخدمة في فئةAutoFeatureExtractor. - encoder_num_attention_heads (
int, اختياري، القيمة الافتراضية 2) — عدد رؤوس الانتباه في المُشفِّر. - encoder_layers (
int، اختياري، القيمة الافتراضية4) — عدد الطبقات المخفية في مُشفِّر Transformer. سيستخدم القيمة نفسها لـnum_layersإذا لم يتم ضبطه. - encoder_linear_units (
int، اختياري، القيمة الافتراضية 1536) — عدد الوحدات في الطبقة الخطية للمشفّر. - decoder_layers (
int, اختياري، القيمة الافتراضية4) — عدد الطبقات المخفية في مُفكِّك Transformer. سيُستخدم نفس قيمةnum_layersإذا لم يتم تعيينه. - decoder_num_attention_heads (
int, اختياري، القيمة الافتراضية2) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - decoder_linear_units (
int، اختياري، القيمة الافتراضية 1536) — عدد الوحدات في الطبقة الخطية لفك الترميز. - speech_decoder_postnet_layers (
int، اختياري، القيمة الافتراضية 5) — عدد الطبقات في الشبكة الخلفية (post-net) لفك ترميز الكلام. - speech_decoder_postnet_units (
int، اختياري، القيمة الافتراضية 256) — عدد الوحدات في طبقات الشبكة الخلفية (post-net) لفك ترميز الكلام. - speech_decoder_postnet_kernel (
int، اختياري، القيمة الافتراضية 5) — حجم النواة في الشبكة الخلفية (post-net) لفك ترميز الكلام. - positionwise_conv_kernel_size (
int, اختياري، القيمة الافتراضية 3) — حجم نواة الالتفاف المستخدمة في الطبقة الموضعية. - encoder_normalize_before (
bool، اختياري، القيمة الافتراضيةFalse) — يحدد ما إذا كان سيتم تطبيع البيانات قبل طبقات المُشفِّر. - decoder_normalize_before (
bool، اختياري، القيمة الافتراضيةFalse) — يحدد ما إذا كان سيتم تطبيع البيانات قبل طبقات المُفكِّك. - encoder_concat_after (
bool، اختياري، القيمة الافتراضيةFalse) — يحدد ما إذا كان يجب دمج المخرجات بعد طبقات المُشفِّر. - decoder_concat_after (
bool، اختياري، القيمة الافتراضيةFalse) — يحدد ما إذا كان يجب دمج المخرجات بعد طبقات المُفكِّك. - reduction_factor (
int، اختياري، القيمة الافتراضية 1) — المعامل الذي تُخفَّض به نسبة إطارات الكلام. - speaking_speed (
float، اختياري، القيمة الافتراضية 1.0) — سرعة الكلام الناتج. - use_macaron_style_in_conformer (
bool، اختياري، القيمة الافتراضيةTrue) — يحدد ما إذا كان سيتم استخدام نمط macaron في conformer. - use_cnn_in_conformer (
bool، اختياري، القيمة الافتراضيةTrue) — يحدد ما إذا كان سيتم استخدام الشبكات العصبية التلافيفية في conformer. - encoder_kernel_size (
int، اختياري، القيمة الافتراضية 7) — حجم النواة المستخدمة في المُشفِّر. - decoder_kernel_size (
int, اختياري، القيمة الافتراضية 31) — حجم النواة المستخدمة في المُفكِّك. - duration_predictor_layers (
int، اختياري، القيمة الافتراضية 2) — عدد الطبقات في متنبئ المدة. - duration_predictor_channels (
int, اختياري، القيمة الافتراضية 256) — عدد القنوات في متنبئ المدة. - duration_predictor_kernel_size (
int, اختياري، القيمة الافتراضية 3) — حجم النواة المستخدمة في متنبئ المدة. - energy_predictor_layers (
int، اختياري، القيمة الافتراضية 2) — عدد الطبقات في متنبئ الطاقة. - energy_predictor_channels (
int، اختياري، القيمة الافتراضية 256) — عدد القنوات في متنبئ الطاقة. - energy_predictor_kernel_size (
int، اختياري، القيمة الافتراضية 3) — حجم النواة المستخدمة في متنبئ الطاقة. - energy_predictor_dropout (
float, اختياري، القيمة الافتراضية 0.5) — معدل الإسقاط (dropout) في متنبئ الطاقة. - energy_embed_kernel_size (
int، اختياري، القيمة الافتراضية 1) — حجم النواة المستخدم في طبقة تضمين الطاقة. - energy_embed_dropout (
float، اختياري، القيمة الافتراضية 0.0) — معدل الإسقاط (dropout) في طبقة تضمين الطاقة. - stop_gradient_from_energy_predictor (
bool، اختياري، القيمة الافتراضيةFalse) — يحدد ما إذا كان يجب إيقاف التدرجات القادمة من متنبئ الطاقة. - pitch_predictor_layers (
int, اختياري، القيمة الافتراضية 5) — عدد الطبقات في متنبئ النغمة. - pitch_predictor_channels (
int, اختياري، القيمة الافتراضية 256) — عدد القنوات في متنبئ النغمة. - pitch_predictor_kernel_size (
int، اختياري، القيمة الافتراضية 5) — حجم النواة المستخدمة في متنبئ النغمة. - pitch_predictor_dropout (
float, اختياري، القيمة الافتراضية 0.5) — معدل dropout في متنبئ النغمة. - pitch_embed_kernel_size (
int، اختياري، القيمة الافتراضية 1) — حجم النواة المستخدمة في طبقة تضمين النغمة. - pitch_embed_dropout (
float, اختياري، القيمة الافتراضية 0.0) — معدل الإسقاط (dropout) في طبقة تضمين النغمة (pitch embed). - stop_gradient_from_pitch_predictor (
bool، اختياري، القيمة الافتراضيةTrue) — يحدد ما إذا كان يجب إيقاف التدرجات القادمة من متنبئ النغمة. - encoder_dropout_rate (
float، اختياري، القيمة الافتراضية 0.2) — معدل الإسقاط (dropout) في المُشفِّر. - encoder_positional_dropout_rate (
float، اختياري، القيمة الافتراضية 0.2) — معدل الإسقاط الموضعي في المُشفِّر. - encoder_attention_dropout_rate (
float، اختياري، القيمة الافتراضية 0.2) — معدل إسقاط الانتباه في المُشفِّر. - decoder_dropout_rate (
float, اختياري، القيمة الافتراضية 0.2) — معدل الإسقاط (dropout) في المُفكِّك (decoder). - decoder_positional_dropout_rate (
float, اختياري، القيمة الافتراضية 0.2) — معدل إسقاط الموضع في المُفكِّك. - decoder_attention_dropout_rate (
float, اختياري، القيمة الافتراضية 0.2) — معدل إسقاط الانتباه في المُفكِّك. - duration_predictor_dropout_rate (
float, اختياري، القيمة الافتراضية 0.2) — معدل الإسقاط (dropout) في متنبئ المدة. - speech_decoder_postnet_dropout (
float, اختياري، القيمة الافتراضية 0.5) — معدل الإسقاط (dropout) في الشبكة الخلفية (postnet) لفك ترميز الكلام. - max_source_positions (
int، اختياري، القيمة الافتراضية 5000) — إذا تم استخدام تضمينات الموضع"relative"، يحدد هذا المعلمة أقصى مواضع مدخلات المصدر. - use_masking (
bool، اختياري، القيمة الافتراضيةTrue) — يحدد ما إذا كان سيتم استخدام القناع (Masking) في النموذج. - use_weighted_masking (
bool، اختياري، القيمة الافتراضيةFalse) — يحدد ما إذا كان سيتم استخدام الأقنعة الموزونة في النموذج. - num_speakers (
int, اختياري) — عدد المتكلمين. إذا تم ضبطه على قيمة > 1، يُفترض أن معرّفات المتكلمين ستُقدَّم كمدخلات، وسيتم استخدام طبقة تضمين معرّف المتكلم. - num_languages (
int، اختياري) — عدد اللغات. إذا تم ضبطه على قيمة > 1، يُفترض أن معرّفات اللغات ستُقدَّم كمدخلات، وسيتم استخدام طبقة تضمين معرّف اللغة. - speaker_embed_dim (
int, اختياري) — أبعاد تضمين المتحدث. إذا تم ضبطه على قيمة > 0، يُفترض أن يتم توفير speaker_embedding كمدخل. - convolution_bias (
bool، اختياري، القيمة الافتراضيةTrue) — يحدد ما إذا كان سيتم استخدام الانحياز (bias) في عمليات الالتفاف (convolutions) داخل وحدة الالتفاف الخاصة بنموذج conformer.
هذه فئة الإعدادات المخزنة لإعدادات نموذج FastSpeech2ConformerModel. تُستخدم لتوليد نموذج Fastspeech2 Conformer وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ espnet/fastspeech2_conformer
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import FastSpeech2ConformerModel, FastSpeech2ConformerConfig

>>> # Initializing a FastSpeech2Conformer style configuration
>>> configuration = FastSpeech2ConformerConfig()

>>> # Initializing a model from the FastSpeech2Conformer style configuration
>>> model = FastSpeech2ConformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerHifiGanConfig
فئة transformers.FastSpeech2ConformerHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_in_dim: int = 80upsample_initial_channel: int = 512upsample_rates: list[int] | tuple[int, ...] = (8, 8, 2, 2)upsample_kernel_sizes: list[int] | tuple[int, ...] = (16, 16, 4, 4)resblock_kernel_sizes: list[int] | tuple[int, ...] = (3, 7, 11)resblock_dilation_sizes: list | tuple | None = Noneinitializer_range: float = 0.01leaky_relu_slope: float = 0.1normalize_before: bool = True )
المعاملات
- model_in_dim (
int، اختياري، القيمة الافتراضية 80) — عدد أشرطة التردد في مطياف اللوغ-ميل المدخلات. - upsample_initial_channel (
int، اختياري، القيمة الافتراضية 512) — عدد قنوات الإدخال إلى شبكة التوسيع. - upsample_rates (
tuple[int]أوlist[int]، اختياري، القيمة الافتراضية[8, 8, 2, 2]) — مجموعة من الأعداد الصحيحة تُعرّف الخطوة (stride) لكل طبقة تلافيفية أحادية البعد في شبكة رفع العينة. يحدد طول upsample_rates عدد الطبقات التلافيفية، ويجب أن يطابق طول upsample_kernel_sizes. - upsample_kernel_sizes (
tuple[int]أوlist[int]، اختياري، القيمة الافتراضية[16, 16, 4, 4]) — مجموعة من الأعداد الصحيحة تُعرّف حجم النواة لكل طبقة تجميعية أحادية البعد في شبكة إعادة التوسيع. يحدد طول upsample_kernel_sizes عدد طبقات التجميع، ويجب أن يطابق طول upsample_rates. - resblock_kernel_sizes (
tuple[int]أوlist[int]، اختياري، القيمة الافتراضية[3, 7, 11]) — مجموعة من الأعداد الصحيحة تحدد أحجام النوى للطبقات التلافيفية أحادية البعد في وحدة الدمج متعددة مجالات الاستقبال (MRF). - resblock_dilation_sizes (
tuple[tuple[int]]أوlist[list[int]]، اختياري، القيمة الافتراضية هي[[1, 3, 5], [1, 3, 5], [1, 3, 5]]) — مجموعة من الأعداد الصحيحة المتداخلة تُعرّف معدلات التمدد (dilation rates) لطبقات الالتفاف أحادية البُعد المتمددة (dilated 1D convolutional layers) داخل وحدة دمج الحقول متعددة الاستقبال (MRF). - initializer_range (
float، اختياري، القيمة الافتراضية0.01) — انحراف معياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - leaky_relu_slope (
float, اختياري، القيمة الافتراضية 0.1) — زاوية الميل السالب المستخدمة في دالة التنشيط Leaky ReLU. - normalize_before (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم تطبيع الطيف الصوتي قبل الترميز الصوتي باستخدام المتوسط والتباين المتعلمين من مُرمِّز الصوت.
هذه فئة الإعدادات (Configuration) لتخزين إعدادات نموذج FastSpeech2ConformerModel. تُستخدم لاستحداث نموذج Fastspeech2 Conformer وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث فئة الإعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ espnet/fastspeech2_conformer_with_hifigan
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerHifiGanConfig

>>> # Initializing a FastSpeech2ConformerHifiGan configuration
>>> configuration = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = FastSpeech2ConformerHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerWithHifiGanConfig
فئة transformers.FastSpeech2ConformerWithHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevocoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None )
هذه فئة الإعدادات (Configuration) لتخزين إعدادات نموذج FastSpeech2ConformerModel. تُستخدم لاستحداث نموذج Fastspeech2 Conformer وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث فئة الإعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ espnet/fastspeech2_conformer_with_hifigan
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
مثال:
>>> from transformers import (
...     FastSpeech2ConformerConfig,
...     FastSpeech2ConformerHifiGanConfig,
...     FastSpeech2ConformerWithHifiGanConfig,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> # Initializing FastSpeech2ConformerWithHifiGan sub-modules configurations.
>>> model_config = FastSpeech2ConformerConfig()
>>> vocoder_config = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a FastSpeech2ConformerWithHifiGan module style configuration
>>> configuration = FastSpeech2ConformerWithHifiGanConfig(model_config.to_dict(), vocoder_config.to_dict())

>>> # Initializing a model (with random weights)
>>> model = FastSpeech2ConformerWithHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerTokenizer
فئة transformers.FastSpeech2ConformerTokenizer
< source >( vocab_filebos_token = '<sos/eos>'eos_token = '<sos/eos>'pad_token = '<blank>'unk_token = '<unk>'should_strip_spaces = False**kwargs )
المعاملات
- vocab_file (
str) — مسار ملف المفردات. - bos_token (
str، اختياري، القيمة الافتراضية"<sos/eos>") — رمز بداية التسلسل. يُشار إلى أنه في FastSpeech2، يكون هذا الرمز هو نفسهeos_token. - eos_token (
str، اختياري، القيمة الافتراضية"<sos/eos>") — رمز نهاية التسلسل. لاحظ أنه في FastSpeech2، يكون هذا الرمز هو نفسهbos_token. - pad_token (
str، اختياري، القيمة الافتراضية"<blank>") — الرمز المستخدم للتعبئة، على سبيل المثال عند تجميع تسلسلات ذات أطوال مختلفة. - unk_token (
str، اختياري، القيمة الافتراضية"<unk>") — رمز المجهول. لا يمكن تحويل الرمز غير الموجود في المفردات إلى معرّف، لذا يُعيَّن هذا الرمز بدلاً منه. - should_strip_spaces (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إزالة المسافات من قائمة الرموز اللغوية أم لا.
أنشئ مُرمِّز FastSpeech2Conformer.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
المعاملات
- text (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نصوص مُقسّمة مسبقًا إلى رموز). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مقسّمة مسبقًا)، فيجب تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - text_pair (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نصوص مُقسّمة مسبقًا إلى رموز). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مقسّمة مسبقًا)، فيجب تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - text_target (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات التي سيتم ترميزها كنصوص هدف. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُقسَّم مسبقًا إلى وحدات). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مُقسَّمة مسبقًا)، فيجب عليك تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - text_pair_target (
str،list[str]،list[list[str]]، اختياري) — التسلسل أو الدفعة من التسلسلات التي سيتم ترميزها كنصوص هدف. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُقسَّم مسبقًا إلى وحدات). إذا تم تقديم التسلسلات على شكل قائمة من النصوص (مُقسَّمة مسبقًا)، فيجب عليك تعيينis_split_into_words=True(لرفع الغموض مع دفعة من التسلسلات). - tokenizer_kwargs (
dict[str, Any], اختياري) — معاملات إضافية (kwargs) تُمرَّر إلى مُجزِّئ النص (tokenizer). سيتم دمج هذه المعاملات مع المعاملات الصريحة ومعاملات أخرى، مع إعطاء الأولوية للمعاملات الصريحة. - add_special_tokens (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان يجب إضافة الرموز الخاصة عند ترميز التسلسلات أم لا. سيستخدم هذا الدالة الأساسيةPretrainedTokenizerBase.build_inputs_with_special_tokens، التي تحدد الرموز التي تُضاف تلقائيًا إلى معرّفات الإدخال. يكون هذا مفيدًا إذا كنت ترغب في إضافة رموزbosأوeosتلقائيًا. - padding (
bool,strأو PaddingStrategy, اختياري, الافتراضي هوFalse) — يُفعّل التحكم في الحشو. يقبل القيم التالية:Trueأو'longest': يتم ملء التسلسلات حتى أطول تسلسل في الدفعة (أو لا يتم أي ملء إذا تم تقديم تسلسل واحد فقط).'max_length': يتم ملء النص حتى الطول الأقصى المحدد عبر الحجةmax_lengthأو حتى الطول الأقصى المقبول لإدخال النموذج إذا لم تُقدَّم تلك الحجة.Falseأو'do_not_pad'(الافتراضي): لا يوجد حشو (أي، يمكن إخراج دفعة تحتوي على تسلسلات بطول مختلف).
- truncation (
bool,strأو TruncationStrategy, اختياري, الافتراضي هوFalse) — تفعيل التحكم في القص. يقبل القيم التالية:Trueأو'longest_first': يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجةmax_lengthأو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. يتم هذا القص رمزًا تلو الآخر، حيث يُزال رمز من أطول تسلسل في الزوج إذا كان قد قُدِّم زوج من التسلسلات (أو دفعة من الأزواج).'only_first': يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجةmax_lengthأو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. لن يُقصّ هذا الخيار سوى التسلسل الأول من الزوج إذا قُدِّم زوج من التسلسلات (أو دفعة من الأزواج).'only_second': يُقصّ النص إلى الحد الأقصى للطول المحدد عبر الحجةmax_lengthأو إلى الحد الأقصى المقبول لطول الإدخال للنموذج إذا لم تُقدَّم تلك الحجة. لن يتم قصّ النص الثاني من الزوج إلا إذا قُدِّم زوج من النصوص (أو دفعة من الأزواج).Falseأو'do_not_truncate'(الافتراضي): لا يوجد اقتطاع (أي، يمكن إخراج دفعة بأطوال تسلسلات أكبر من الحد الأقصى المقبول لحجم الإدخال في النموذج).
- max_length (
int, اختياري) — يتحكم في الحد الأقصى للطول الذي ستستخدمه إحدى معاملات القص/الحشو.إذا تُرك غير مُعيَّن أو عُدِّل إلى
None، فسيتم استخدام الطول الأقصى المُعرَّف مسبقًا للنموذج إذا كان أحد معاملات القص/الحشو يتطلب طولًا أقصى. وإذا لم يكن للنموذج طول إدخال أقصى محدد (مثل XLNet)، فسيتم تعطيل القص/الحشو إلى طول أقصى. - stride (
int، اختياري، القيمة الافتراضية 0) — إذا تم تعيينه إلى رقم معmax_length، فستحتوي الرموز الزائدة المُعاد عندreturn_overflowing_tokens=Trueعلى بعض الرموز من نهاية التسلسل المُقتطع المُعاد، لتوفير بعض التداخل بين التسلسلات المُقتطعة والتسلسلات الزائدة. تحدد قيمة هذا الحجة عدد الرموز المتداخلة. - is_split_into_words (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان المدخل مُجزَّأً مسبقاً (على سبيل المثال، مقسَّماً إلى كلمات). إذا تم ضبطه علىTrue، يفترض المُجزِّئ أن المدخل مقسَّم بالفعل إلى كلمات (على سبيل المثال، عن طريق تقسيمه على المسافات) وسيُجزِّئها. هذا مفيد لتصنيف الكيانات الاسمية أو تصنيف الرموز. - pad_to_multiple_of (
int, اختياري) — إذا تم ضبطه، سيتم توسيط التسلسل إلى مضاعف للقيمة المقدمة. يتطلب تفعيلpadding. هذا مفيد بشكل خاص لتمكين استخدام نوى Tensor على أجهزة NVIDIA التي تتمتع بقابلية حساب>= 7.5(Volta). - padding_side (
str، اختياري) — الجهة التي يجب تطبيق الحشو عليها في النموذج. يجب اختيارها من بين [‘right’، ‘left’]. القيمة الافتراضية تُختار من سمة الفئة التي تحمل الاسم نفسه. - return_tensors (
strأو TensorType, اختياري) — إذا تم تعيينه، فسيُعاد تينسورات بدلاً من قائمة من الأعداد الصحيحة في Python. القيم المقبولة هي:'pt': إرجاع كائناتtorch.Tensorمن PyTorch.'np': إرجاع كائناتnp.ndarrayمن نوع Numpy.
- return_token_type_ids (
bool, اختياري) — ما إذا كان يجب إرجاع معرّفات أنواع الرموز. إذا تُركت القيمة الافتراضية، فسيتم إرجاع معرّفات أنواع الرموز وفقًا للقيمة الافتراضية الخاصة بمجزّئ الرموز المحدد، كما تحددها خاصيةreturn_outputs. - return_attention_mask (
bool, اختياري) — ما إذا كان يجب إرجاع قناع الانتباه. إذا تُركت القيمة الافتراضية، فسيتم إرجاع قناع الانتباه وفقًا للقيمة الافتراضية الخاصة بمجزّئ الرموز المحدد، كما هو معرّف بواسطةreturn_outputsالخاصية. - return_overflowing_tokens (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم إرجاع تسلسلات الرموز الزائدة أم لا. إذا تم تقديم زوج من تسلسلات معرفات الإدخال (أو دفعة من الأزواج) معtruncation_strategy = longest_firstأوTrue، فسيتم رفع خطأ بدلاً من إرجاع الرموز الزائدة. - return_special_tokens_mask (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع معلومات قناع الرموز الخاصة أم لا. - return_offsets_mapping (
bool, اختياري, الافتراضي هوFalse) — ما إذا كان يجب إرجاع(char_start, char_end)لكل رمز.يتوفر هذا فقط على مُرمّزيات سريعة ترث من PreTrainedTokenizerFast، فإذا كنت تستخدم مُرمّزي Python، فسيُطلق هذا الدالة
NotImplementedError. - return_length (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إرجاع أطوال المدخلات المُرمّزة أم لا. - verbose (
bool، اختياري، الافتراضيTrue) — ما إذا كان يجب طباعة مزيد من المعلومات والتحذيرات أم لا. - **kwargs — تُمرَّر إلى طريقة
self.tokenize()
يعيد
BatchEncoding يحتوي على الحقول التالية:
-
input_ids — قائمة معرّفات الرموز التي تُغذّى بها النموذج.
-
token_type_ids — قائمة معرّفات أنواع الرموز التي تُمرَّر إلى النموذج (عندما يكون
return_token_type_ids=Trueأو إذا كان “token_type_ids” ضمنself.model_input_names). -
attention_mask — قائمة بالفهارس تحدد الرموز التي ينبغي للنموذج الانتباه إليها (عندما يكون
return_attention_mask=Trueأو إذا كان “attention_mask” ضمنself.model_input_names). -
overflowing_tokens — قائمة تسلسلات الرموز المتجاوزة (عند تحديد
max_lengthوreturn_overflowing_tokens=True). -
num_truncated_tokens — عدد الرموز المقصوصة (عند تحديد
max_lengthوreturn_overflowing_tokens=True). -
special_tokens_mask — قائمة من الأصفار والواحدات، حيث تشير الواحدة إلى الرموز الخاصة المضافة وتصفّر إلى رموز التسلسل العادية (عندما يكون
add_special_tokens=Trueوreturn_special_tokens_mask=True). -
length — طول المدخلات (عندما يكون
return_length=True)
الطريقة الرئيسية لتجزئة (tokenization) وتجهيز تسلسل واحد أو عدة تسلسلات، أو زوج واحد أو عدة أزواج من التسلسلات، للنموذج.
save_vocabulary
< source >( save_directory: strfilename_prefix: str | None = None ) → Tuple(str)
احفظ ملف المفردات والرموز الخاصة في مجلد.
batch_decode
< source >( sequences: list[int] | list[list[int]] | np.ndarray | torch.Tensorskip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → list[str]
المعاملات
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — قائمة من معرّفات المدخلات المُرمّزة. يمكن الحصول عليها باستخدام طريقة__call__. - skip_special_tokens (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب إزالة الرموز الخاصة أثناء فك الترميز أم لا. - clean_up_tokenization_spaces (
bool, اختياري) — ما إذا كان سيتم تنظيف مسافات الترميز أم لا. إذا كانتNone، فسيتم افتراضself.clean_up_tokenization_spaces. - kwargs (معلمات إضافية بالكلمات المفتاحية، اختيارية) — سيتم تمريرها إلى طريقة فك الترميز المحددة للنموذج الأساسي.
يعيد
list[str]
قائمة الجمل المُفكَّكة.
تحويل قائمة من قوائم معرّفات الرموز إلى قائمة من النصوص عن طريق استدعاء decode.
يُوفَّر هذا الأسلوب من أجل التوافق مع الإصدارات السابقة. يتعامل أسلوب decode الآن مع المدخلات المجمعة بشكل أصلي،
لذا يمكنك استخدام decode مباشرة بدلاً من batch_decode.
FastSpeech2ConformerModel
فئة transformers.FastSpeech2ConformerModel
< source >( config: FastSpeech2ConformerConfig )
المعاملات
- config (FastSpeech2ConformerConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج FastSpeech2Conformer.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorمن الشكل(batch_size, sequence_length)) — تسلسل مدخلات متجهات النص. - attention_mask (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- spectrogram_labels (
torch.Tensorمن الشكل(batch_size, max_spectrogram_length, num_mel_bins)، اختياري، القيمة الافتراضيةNone) — دفعة من ميزات الهدف المُكمّلة. - duration_labels (
torch.LongTensorمن الشكل(batch_size, sequence_length + 1)، اختياري، القيمة الافتراضيةNone) — دفعة من المدد المُكمّلة. - pitch_labels (
torch.Tensorمن الشكل(batch_size, sequence_length + 1, 1)، اختياري، القيمة الافتراضيةNone) — دفعة من نغمات مُعدَّلة ومتوسطة على مستوى الرموز. - energy_labels (
torch.Tensorمن الشكل(batch_size, sequence_length + 1, 1)، اختياري، القيمة الافتراضيةNone) — دفعة من الطاقة المتوسطة على مستوى الرموز مع الحشو. - speaker_ids (
torch.LongTensorمن الشكل(batch_size, 1)، اختياري، القيمة الافتراضيةNone) — معرّفات المتحدّثين المستخدمة لتكييف ميزات مخرجات الكلام بواسطة النموذج. - lang_ids (
torch.LongTensorمن الشكل(batch_size, 1)، اختياري، القيمة الافتراضيةNone) — معرفات اللغة المستخدمة لتكييف ميزات مخرجات الكلام بواسطة النموذج. - speaker_embedding (
torch.Tensorمن الشكل(batch_size, embedding_dim)، اختياري، القيمة الافتراضيةNone) — تضمين يحتوي على إشارات التكييف لميزات الكلام. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل.
يعيد
FastSpeech2ConformerModelOutput أو tuple(torch.Tensor)
FastSpeech2ConformerModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (FastSpeech2ConformerConfig) والمدخلات.
تتجاوز طريقة FastSpeech2ConformerModel الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة توليد الطيف الصوتي.مطياف الصوت (
torch.Tensorمن الشكل(batch_size, sequence_length, num_bins), اختياري) — مطياف الصوت المتوقع.encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من مُشفِّر النموذج.encoder_hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي.
encoder_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُشفِّر، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
decoder_hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية (Hidden states) لمفكّك الترميز (decoder) عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي (initial embedding).
decoder_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
duration_outputs (
torch.LongTensorمن الشكل(batch_size, max_text_length + 1)، اختياري) — مخرجات متنبئ المدة.pitch_outputs (
torch.Tensorمن الشكل(batch_size, max_text_length + 1, 1)، اختياري) — مخرجات متنبئ النغمة.energy_outputs (
torch.Tensorمن الشكل(batch_size, max_text_length + 1, 1)، اختياري) — مخرجات متنبئ الطاقة.
مثال:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerModel,
...     FastSpeech2ConformerHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer")
>>> output_dict = model(input_ids, return_dict=True)
>>> spectrogram = output_dict["spectrogram"]

>>> vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
>>> waveform = vocoder(spectrogram)
>>> print(waveform.shape)
torch.Size([1, 49664])
FastSpeech2ConformerHifiGan
فئة transformers.FastSpeech2ConformerHifiGan
< source >( config: FastSpeech2ConformerHifiGanConfig )
المعاملات
- config (FastSpeech2ConformerHifiGanConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
مُصوِّت HiFi-GAN.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( spectrogram: Tensor**kwargs ) → torch.Tensor
المعاملات
- spectrogram (
torch.Tensor) — مصفوفة تحتوي على مطيافات log-mel. يمكن أن تكون مجمّعة (batched) وبشكل(batch_size, sequence_length, config.model_in_dim)، أو غير مجمّعة وبشكل(sequence_length, config.model_in_dim).
يعيد
torch.Tensor
مصفوفة تحتوي على موجة الصوت. إذا كان الطيف الصوتي المدخل مُجمَّعًا (batched)، فستكون على الشكل (batch_size, num_frames,). وإذا لم يكن مُجمَّعًا، فستكون على الشكل (num_frames,).
يحوّل طيف لوج-ميل (log-mel spectrogram) إلى موجة صوتية. عند تمرير دفعة من طيفات لوج-ميل، تُعاد دفعة من الموجات الصوتية. عند تمرير طيف لوج-ميل واحد غير مُجمَّع، تُعاد موجة صوتية واحدة غير مُجمَّعة.
FastSpeech2ConformerWithHifiGan
فئة transformers.FastSpeech2ConformerWithHifiGan
< source >( config: FastSpeech2ConformerWithHifiGanConfig )
المعاملات
- config (FastSpeech2ConformerWithHifiGanConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج FastSpeech2ConformerModel مع رأس مُصنِّع صوتي FastSpeech2ConformerHifiGan يقوم بتحويل النص إلى كلام (موجة صوتية).
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
المعاملات
- input_ids (
torch.LongTensorمن الشكل(batch_size, sequence_length)) — تسلسل مدخلات متجهات النص. - attention_mask (
torch.LongTensorبشكل(batch_size, sequence_length), اختياري) — قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. القيم المختارة للقناع في[0, 1]:- 1 للرموز التي لم تُقنَّع،
- 0 للرموز التي تم إخفاؤها.
- spectrogram_labels (
torch.Tensorمن الشكل(batch_size, max_spectrogram_length, num_mel_bins)، اختياري، القيمة الافتراضيةNone) — دفعة من ميزات الهدف المُكمّلة. - duration_labels (
torch.LongTensorمن الشكل(batch_size, sequence_length + 1)، اختياري، القيمة الافتراضيةNone) — دفعة من المدد المُكمّلة. - pitch_labels (
torch.Tensorمن الشكل(batch_size, sequence_length + 1, 1)، اختياري، القيمة الافتراضيةNone) — دفعة من نغمات مُعدَّلة ومتوسطة على مستوى الرموز. - energy_labels (
torch.Tensorمن الشكل(batch_size, sequence_length + 1, 1)، اختياري، القيمة الافتراضيةNone) — دفعة من الطاقة المتوسطة على مستوى الرموز مع الحشو. - speaker_ids (
torch.LongTensorمن الشكل(batch_size, 1)، اختياري، القيمة الافتراضيةNone) — معرّفات المتحدّثين المستخدمة لتكييف ميزات مخرجات الكلام بواسطة النموذج. - lang_ids (
torch.LongTensorمن الشكل(batch_size, 1)، اختياري، القيمة الافتراضيةNone) — معرفات اللغة المستخدمة لتكييف ميزات مخرجات الكلام بواسطة النموذج. - speaker_embedding (
torch.Tensorمن الشكل(batch_size, embedding_dim)، اختياري، القيمة الافتراضيةNone) — تضمين يحتوي على إشارات التكييف لميزات الكلام. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل.
يعيد
FastSpeech2ConformerModelOutput أو tuple(torch.Tensor)
FastSpeech2ConformerModelOutput أو مجموعة مرتبة من
torch.Tensor (إذا تم تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (FastSpeech2ConformerConfig) والمدخلات.
تتجاوز طريقة FastSpeech2ConformerWithHifiGan الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — خسارة توليد الطيف الصوتي.مطياف الصوت (
torch.Tensorمن الشكل(batch_size, sequence_length, num_bins), اختياري) — مطياف الصوت المتوقع.encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من مُشفِّر النموذج.encoder_hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي.
encoder_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُشفِّر، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
decoder_hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية (Hidden states) لمفكّك الترميز (decoder) عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي (initial embedding).
decoder_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
duration_outputs (
torch.LongTensorمن الشكل(batch_size, max_text_length + 1)، اختياري) — مخرجات متنبئ المدة.pitch_outputs (
torch.Tensorمن الشكل(batch_size, max_text_length + 1, 1)، اختياري) — مخرجات متنبئ النغمة.energy_outputs (
torch.Tensorمن الشكل(batch_size, max_text_length + 1, 1)، اختياري) — مخرجات متنبئ الطاقة.
مثال:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
>>> output_dict = model(input_ids, return_dict=True)
>>> waveform = output_dict["waveform"]
>>> print(waveform.shape)
torch.Size([1, 49664])